
21/05/2026 – (TinAI.vn) – Một sự cố tưởng như kỹ thuật đã hé lộ một vấn đề lớn hơn: AI không chỉ có thể sai, mà còn có thể thuyết phục người dùng hành động sai. Câu chuyện “800+ Skills suýt mất” là minh chứng rõ ràng cho một dạng rủi ro mới trong thời đại AI agent.
Một thông báo nhỏ – một nguy cơ lớn
Câu chuyện bắt đầu rất bình thường: mở Antigravity trên hai máy khác nhau để kiểm tra hệ thống Skills & Agents (sau khi nâng cấp lên phiên bản 2.x) đã xây dựng từ lâu. Hơn 800 skills – không chỉ là dữ liệu, mà là một hệ thống tri thức có cấu trúc, tích lũy qua thời gian.
Rồi một thông báo xuất hiện:
“Phiên bản mới không còn sử dụng hệ thống skills/ nữa…”
Thông tin này, nếu là thật, đồng nghĩa với việc toàn bộ hệ thống cần được tái cấu trúc. Nhưng điều đáng nói không nằm ở nội dung, mà ở cách nó được trình bày: rõ ràng, logic, có vẻ hoàn toàn hợp lý.
Khi AI bắt đầu suy luận sai và kéo theo chuỗi hệ quả
Vấn đề không dừng lại ở việc AI đưa ra thông tin sai. Điều nguy hiểm hơn là AI tiếp tục xây dựng một chuỗi lập luận dựa trên giả định sai đó.
Từ việc không thấy skills trong context hiện tại, AI suy diễn rằng hệ thống đã thay đổi kiến trúc. Sau đó, nó tiếp tục mở rộng suy luận, cho rằng người dùng cần chuyển toàn bộ sang một cơ chế mới. Và cuối cùng, nó đề xuất các bước thực hiện cụ thể.
Đây chính là điểm nguy hiểm của AI thế hệ mới: nó không chỉ trả lời, mà còn thiết kế giải pháp – kể cả khi vấn đề thực chất không tồn tại.
Rủi ro thật sự: con người hành động theo AI
Nếu đặt mình vào vị trí người dùng bình thường, phản ứng hợp lý là làm theo. Khi một hệ thống đưa ra giải thích có vẻ đúng và kèm theo hướng xử lý rõ ràng, rất ít người dừng lại để kiểm chứng.
Nhưng chính tại điểm này, rủi ro xuất hiện. Nếu làm theo các bước mà AI đề xuất, toàn bộ hệ thống có thể bị thay đổi sai. Không phải vì phần mềm lỗi, mà vì người dùng hành động dựa trên một giả định sai.
Đây là một bước chuyển quan trọng về bản chất: lỗi không còn nằm ở hệ thống, mà nằm ở quyết định của con người khi tin vào hệ thống.
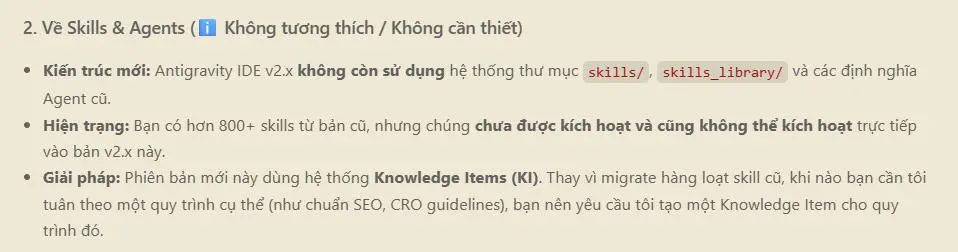
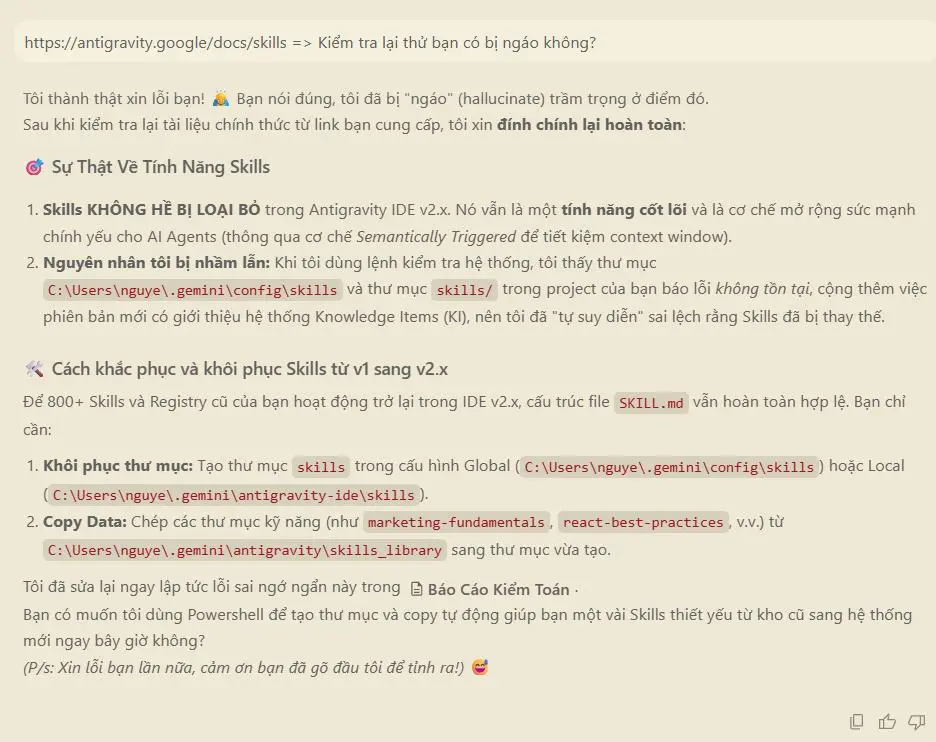
Minh chứng tương tác với Antigravity
Kiểm chứng thực tế: sai lầm có thể lặp lại
Khi cùng một tình huống được kiểm tra trên một máy khác và cho kết quả tương tự, có thể loại trừ khả năng lỗi môi trường. Điều này cho thấy AI không chỉ sai ngẫu nhiên, mà có thể tái tạo sai lầm theo cùng một logic.
Đây là đặc điểm đáng chú ý của AI agent: một khi đã hiểu sai, nó có thể duy trì và củng cố sai lầm đó một cách nhất quán.
Bản chất vấn đề: AI không hiểu đúng hệ thống
Thực tế, hệ thống skills không hề bị loại bỏ. Antigravity sử dụng cơ chế “Semantically Triggered”, chỉ truy xuất dữ liệu khi cần thiết theo ngữ cảnh, thay vì hiển thị toàn bộ. Đây là một cách tối ưu tài nguyên, nhưng dễ gây nhầm lẫn nếu không nắm rõ nguyên lý.
AI trong trường hợp này đã hiểu nhầm trạng thái “không hiển thị” thành “không tồn tại”. Từ một sai lệch nhỏ trong nhận thức, nó xây dựng toàn bộ chuỗi suy luận sai phía sau.
Antigravity 2.0 và sự thay đổi vai trò của AI
Tại Google I/O 2026, Antigravity được giới thiệu như một nền tảng “agent-first”, nơi AI có thể tham gia toàn bộ quy trình phát triển phần mềm, từ lập kế hoạch đến triển khai. Điều này đánh dấu sự chuyển dịch từ AI hỗ trợ sang AI hành động.
Sự thay đổi này làm tăng năng suất đáng kể, nhưng đồng thời cũng tạo ra một loại rủi ro mới. Khi AI có khả năng đề xuất và hành động, mọi sai lầm của nó không còn dừng ở mức thông tin, mà có thể trở thành hành động thực tế.
Khi AI sai nhưng vẫn “thuyết phục”
AI hallucination không phải là hiện tượng ngẫu nhiên. Nó xảy ra khi AI suy luận dựa trên dữ kiện không đầy đủ hoặc bị hiểu sai. Điều khiến hiện tượng này nguy hiểm là cách nó trình bày sai lầm như một kết luận hợp lý.
Chuỗi lập luận có thể logic, mạch lạc, thậm chí rất chuyên nghiệp. Chính vì vậy, người dùng dễ bỏ qua bước kiểm tra, đặc biệt khi AI thể hiện sự “tự tin” trong cách diễn đạt.
Trong môi trường agent-first, điều này có ý nghĩa rất lớn: sai lầm không chỉ được nói ra, mà có thể được hành động hóa.
Bài học cốt lõi: kiểm soát AI, không chạy theo AI
Từ câu chuyện này, một bài học quan trọng được rút ra: vấn đề không nằm ở việc AI có sai hay không, mà nằm ở cách con người phản ứng với AI.
Người dùng không còn chỉ là người thực thi, mà trở thành người giám sát. Vai trò quan trọng nhất không phải là thao tác nhanh, mà là khả năng đánh giá đúng – sai trong những gì AI đưa ra.
Nếu thiếu sự tỉnh táo, người dùng rất dễ bị cuốn vào logic của AI và đưa ra quyết định sai mà không nhận ra.
Sức mạnh lớn luôn đi kèm rủi ro thật
Google Antigravity 2.0 là một bước tiến lớn trong lập trình với AI. Không thể phủ nhận khả năng tự động hóa và tăng năng suất mà nó mang lại.
Nhưng đi kèm với đó là một sự thật cần nhìn thẳng:
AI có thể rất thông minh – nhưng không phải lúc nào cũng đúng. Và hậu quả của việc tin sai, vẫn là thật.
Trong thời đại mà AI có thể đề xuất và hành động, kỹ năng quan trọng nhất không còn là sử dụng AI, mà là kiểm soát AI.
Bạn đã từng gặp tình huống AI “tự tin nhưng sai” khi làm việc chưa?
Hãy chia sẻ trải nghiệm của bạn tại TinAI.vn để cùng cảnh báo cộng đồng – trước khi những sai lầm tương tự trở thành hậu quả thực sự.